벡터 DB란? ChromaDB 사용해보기
벡터 DB란? ChromaDB 사용해보기 — #벡터DB란 #ChromaDB #개발자의도구들 벡터 DB란? 전통적인 DB는 쿼리기반 검색을 수행합니다. 예...
#벡터DB란 #ChromaDB #개발자의도구들
벡터 DB란?
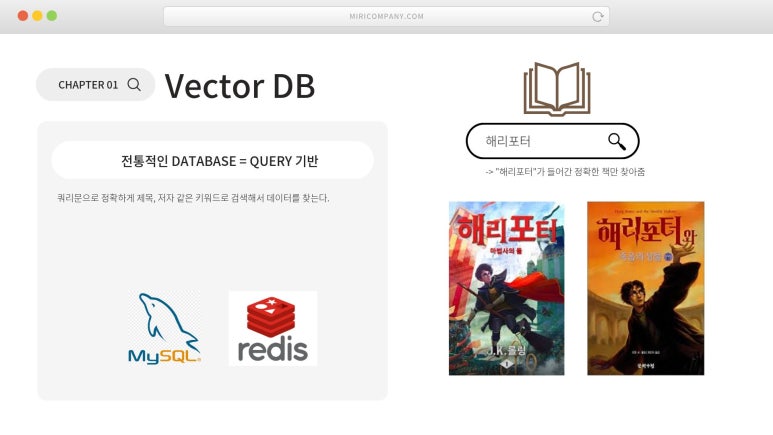
전통적인 DB는 쿼리기반 검색을 수행합니다. 예를들어 도서관 정보시스템에 "해리포터"를 검색하면 해리포터키워드가 들어가는 책을 모두 찾아줍니다.
- 일반적으로 우리가 많이 사용하는 MySQL, Redis 등이 이에 해당합니다.
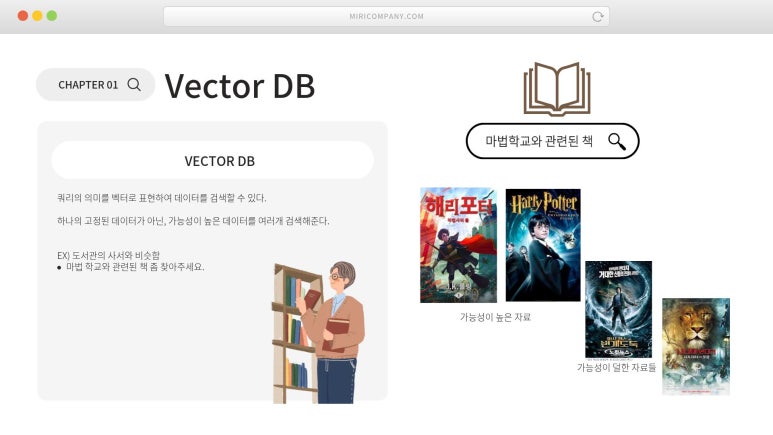
벡터DB의 경우에는 조금다릅니다. 정보시스템에 직접 키워드를 검색하는 것 보다는 사서에게 질문하는 것과 비슷합니다.
"마법 학교와 관련된 책을 찾아주세요"라고 질의하면 사서는 관련된 책들을 여러개 찾아줍니다. 해리포터, 해리포터 영문판, 나니아 연대기, 퍼시잭슨 등 질의와 최대한 관련된 책들을 찾아줍니다.
해당 원리는 아래에서 이어 설명하겠습니다.
ChromaDB
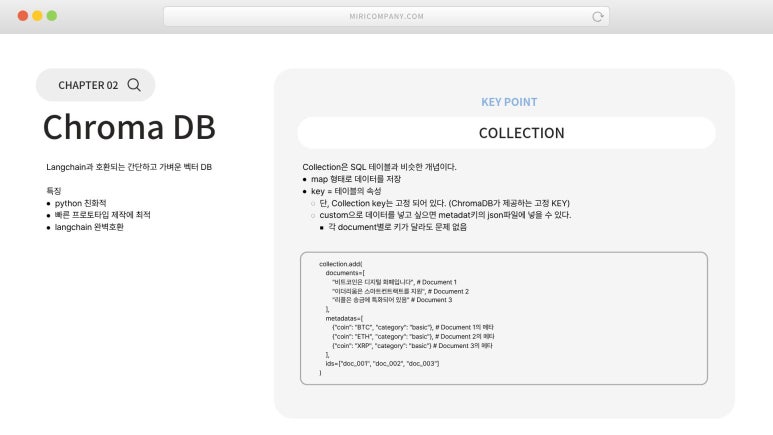
대표적인 백터DB로는 ChromaDB가 존재합니다. Langchain과 완벽호환 되며 python과 친화적인 벡터 DB입니다.
ChromaDB의 구조를 말씀드리겠습니다.
📌Collection
RDBMS의 테이블과 비슷한 개념입니다.
- map 형태로 데이터를 저장합니다.
- key가 해당 데이터의 속성에 해당합니다.
- 단, collection key는 ChromDB에서 고정해둡니다.
                                    collection.add(
    documents=[
        "비트코인은 디지털 화폐입니다", # Document 1
        "이더리움은 스마트컨트랙트를 지원", # Document 2
        "리플은 송금에 특화되어 있음" # Document 3
    ],
    metadatas=[
        {"coin": "BTC", "category": "basic"}, # Document 1의 메타
        {"coin": "ETH", "category": "basic"}, # Document 2의 메타
        {"coin": "XRP", "category": "basic"} # Document 3의 메타
    ],
    ids=["doc_001", "doc_002", "doc_003"]
)
이런식으로 구조화되어있습니다. 여기서 데이터의 속성을 추가하고 싶다면 metadata에 추가해서 넣을 수 있습니다.
각 데이터는 index를 통해 분류됩니다.
📌Document
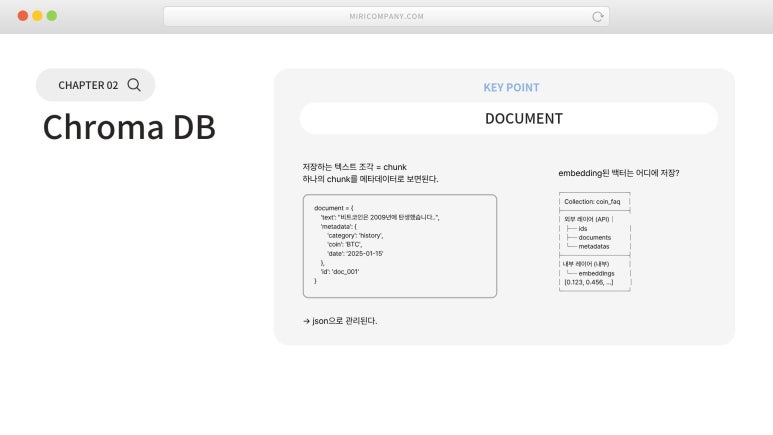
Document는 위의 Collection에 들어가는 하나의 데이터 덩어리입니다. RDBMS의 row와 비슷합니다.
                                    document = {
    'text': "비트코인은 2009년에 탄생했습니다..",
    'metadata': {
        'category': 'history',
        'coin': 'BTC',
        'date': '2025-01-15'
    },
    'id': 'doc_001'
}
Document에는 원본데이터(보통은 Chunk로 나눠짐)가 들어가고 추가적으로 해당 전체 텍스트에 대한 metadata가 들어갑니다.
- 여기서 metadata는 보통 chunk로 나뉘기전의 전체 데이터를 저장합니다.
                                    ┌─────────────────────────┐
│ Collection: coin_faq    │
├─────────────────────────┤
│ 외부 레이어 (API)       │
│ ├─ ids                  │
│ ├─ documents            │
│ └─ metadatas            │
├─────────────────────────┤
│내부 레이어 (내부)       │
│ └─ embeddings           │
│ [0.123, 0.456, ...]     │
└─────────────────────────┘
embedding 벡터는 사용자에게 노출되지 않는 내부 레이어에 저장됩니다. (그렇다고 못 보는건 아닙니다)
개발자가 고려해야할 것들
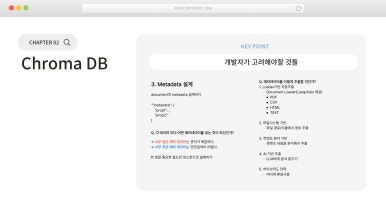
개발자는 VectorDB를 사용하기 위해 다음을 고려해야합니다.
- Chunking: 어떻게 원본 텍스트를 자를 것인가?
- Embedding: 어떤 Embedding 모델을 사용할 것인가?
- Metadata설계: 원본 데이터의 어떤 속성을 추출할 것인가?
- Metadata를 설계했다면 어떻게 추출할 것인가?
- Langchain Loader 기반 자동 추출
- 파일시스템 기반: 파일경로/이름
- 콘텐츠 분석
- AI 기반 추출: LLM에게 맡겨서 추출
- 하이브리드: 여러가지 전략
프로젝트 업데이트
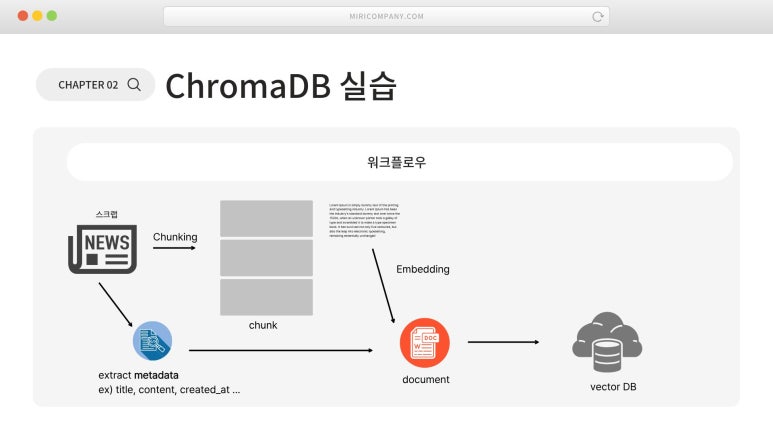
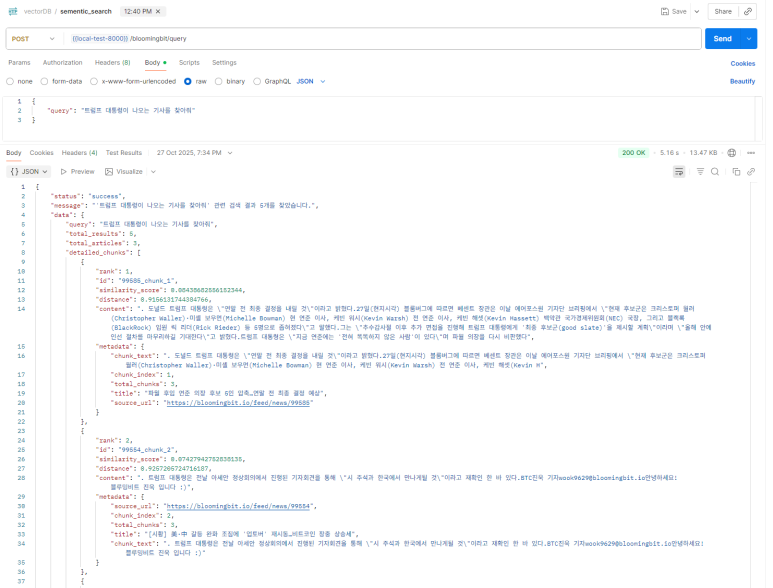
뉴스 기사를 크롤링 후 metadata추출 및 임베딩을 진행했습니다.
이후 vectorDB에 저장했습니다.
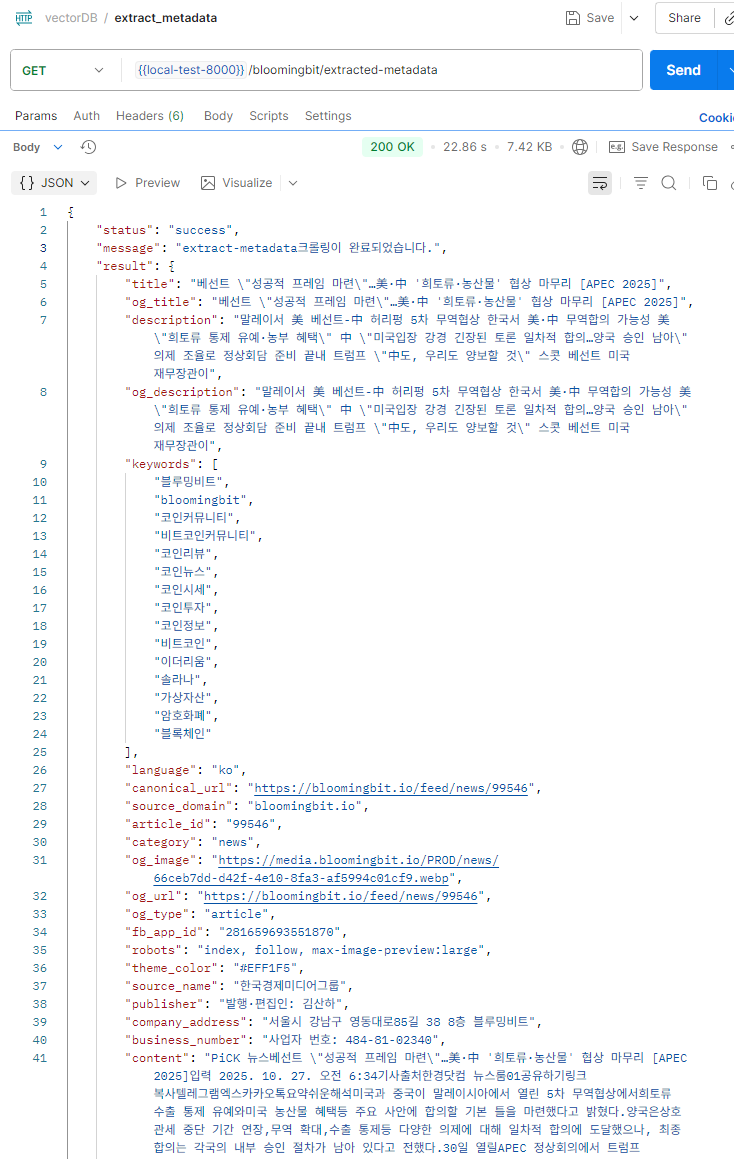
🪠 extarct metadata
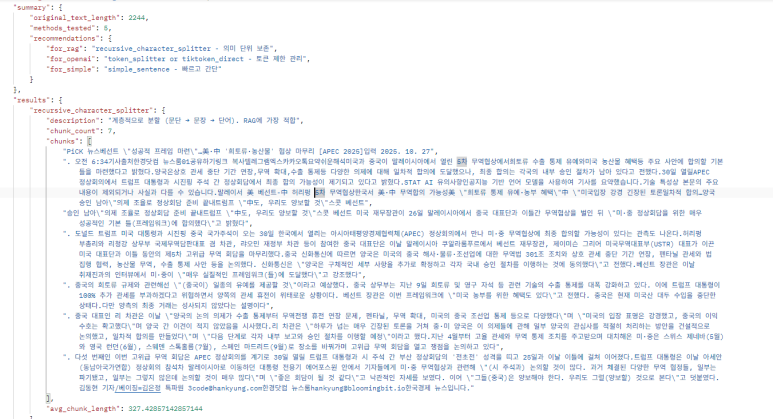
📜 Chunking
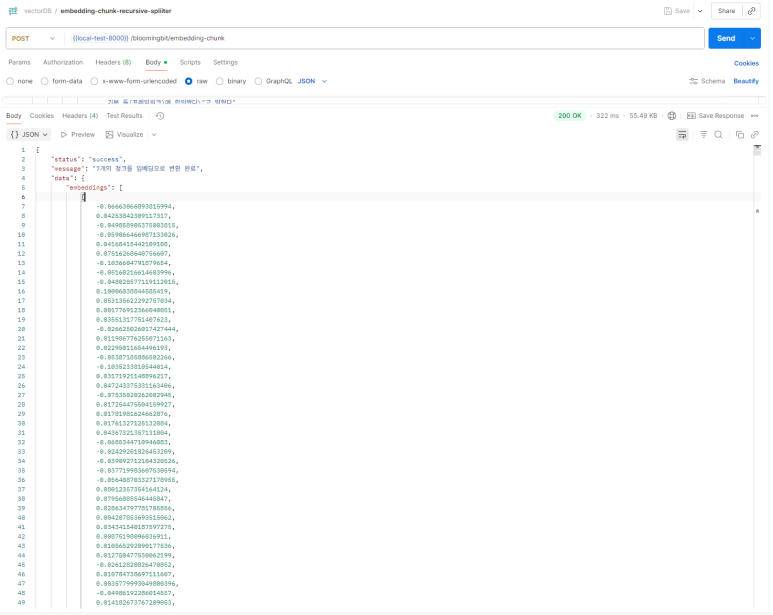
🍳 Embedding
Sementic Search
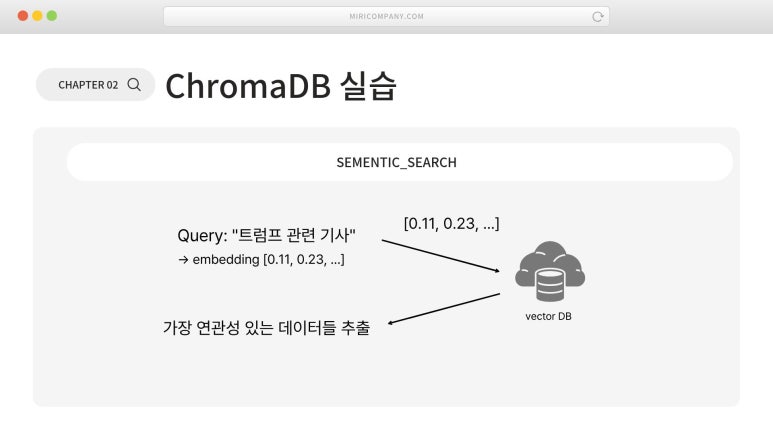
기존 DB 쿼리와 다르게 "트럼프 관련 기사"로 검색하면 가장 연관성 있는 chunk가 추출됩니다.